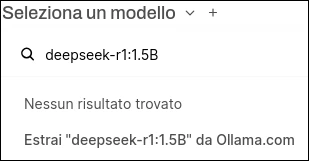
L'integrazione con Ollama permette di acquisire un modello semplicemente digitando il suo nome nella casella di ricerca in "Seleziona un modello", e poi cliccare su "Estrai [nome modello] da Ollama.com".
La tanto chiacchierata DeepSeek, azienda cinese specializzata nella produzione di LLM (Large Language Model), promette di rivoluzionare il mondo delle AI riducendo drasticamente costi, consumi e potenza di calcolo necessari per gestire modelli linguistici di grandi dimensioni.
Ma è davvero così? Spoiler: No. O meglio; i maggiori benefici si avranno a livello enterprise.
Se finora la creazione, l'addestramento e la gestione di un LLM hanno richiesto costi talmente spropositati da restare appannaggio esclusivo delle più ricche Big Tech del pianeta, ora anche altri attori potrebbero essere coinvolti.
Però no, non farete ancora concorrenza ad OpenAI con il vostro Rasperry.
Ogni fornitore di LLM, fondamentalmente, offre un servizio freemium sul proprio sito o su app, con funzionalità e prestazioni che rasentano la perfezione, e qualche limite nella versione gratuita.
Nella quasi totalità dei chatbot online, però, viene chiaramente indicato nelle condizioni d'uso che qualsiasi dato immesso dall'utente diverrà di proprietà della rispettiva azienda fornitrice e sarà utilizzato per l'addestramento dei modelli.
Non mancano nemmeno possibili censure, più o meno velate, ma inevitabili quando i modelli girano su server proprietari.
Di certo non una prerogativa di DeepSeek, ma il rilascio gratuito e con licenza open source dei loro modelli per uso locale ha aperto a sviluppi interessanti.
I modelli sono relativamente leggeri da eseguire nelle loro varianti più basiche (fino a circa 7 milardi di parametri), non richiedono espressamente la presenza di una GPU dedicata e possono essere eseguiti anche su CPU di fascia medio/alta prodotte dal 2016 in poi, meglio se accompagnate da almeno 16 GB di RAM. Non si tratta di calcoli empirici, quanto di dati basati su prove e tentativi.
Ci sono tanti fattori in gioco, tra cui la vostra pazienza; in ogni caso non aspettatevi risposte rapide su hardware poco recente.
Ogni interrogazione può avere impatti differenti sul modello, costretto a "pensare" di più, con conseguente aumento delle risorse impiegate. In quest'ottica è bene valutare anche il rapporto consumi/benefici.
Senza entrare in spinosi tecnicismi, è doverosa una precisazione.
Il "vero" DeepSeek è quello da 671B (ossia il modello con più di 670 miliardi di parametri). Le varianti ridotte sono composte da una base che attinge da altri LLM disponibili (Qwen o Llama) e arricchiti (o distillati) con alcuni dati pronti estratti dal modello più grande.
Attenzione: modelli ridotti producono maggiori allucinazioni ed errori, ed hanno più difficoltà ad esprimersi correttamente in italiano.
Nonostante l'impatto molto positivo sulla privacy, è fondamentale verificare la correttezza degli output prodotti. Mai come in questo caso, l'utente deve essere consapevole dei limiti di questi strumenti, specie nelle loro versioni "casalinghe".
Ma veniamo a noi.
Ollama è un software open source e multipiattaforma per l'esecuzione di LLM locali; proprio quello che ci occorre!
Per consuetudine la rappresentazione dei comandi avviene con il prefisso "$ ", che non va digitato nella shell.La sua installazione è banale se si segue il metodo suggerito sul sito ufficiale:
$ curl -fsSL https://ollama.com/install.sh | sh Al momento della stesura dell'articolo la procedura per Linux prevede l'esecuzione di uno script remoto. In caso di dubbi e perplessità è possibile visionare il codice di esso, o procedere con altri tipi di installazione. $ ollama run deepseek-r1:1.5b Per cominciare a sporcarsi le mani, il modello più piccolo richiederà pochi dati per il download e risorse non troppo impegnative per la sua esecuzione. All'aumentare dei parametri, tutto crescerà proporzionalmente. I modelli DeepSeek contrassegnati dalla sigla r1 si differenziano da quelli più classici proprio per la loro capacità di "pensare" e "ragionare" sulla domanda posta dall'utente. La lettura di questi "pensieri" ha provocato in me un misto di fascinazione, ilarità ed inquietudine.
A parte le mie sensazioni, comunque, il meccanismo di "pensiero" dovrebbe aumentare l'accuratezza a scapito delle prestazioni .
Una lista dei modelli disponibili (pensanti e non) e facilmente integrabili in Ollama si può trovare in questa sezione del sito.
L'uso di Ollama da terminale, volendo anche in modo più isolato se confinato all'interno di un container systemd-nspawn, è sicuramente il modo più efficiente di eseguire un LLM sul vostro hardware, ma anche quello più spartano.
Per un'esperienza più comoda e simile a quello che otterreste con un chatbot online, si può optare per un container di Open WebUI (anch'esso open source), un'interfaccia grafica per strumenti come Ollama.
Il comando seguente richiede l'installazione di Docker o Podman (usato nell'esempio) come prerequisito: $ podman run -d --name openwebui -p 3000:8080 -e WEBUI_AUTH=False ghcr.io/open-webui/open-webui:ollama
Seppur molto breve e semplice, procediamo comunque ad una piccola analisi del comando impartito.
Si scarica l'immagine dall'url ghcr.io/open-webui/open-webui:ollama e si avvia un container con nome personalizzato openwebui in modalità detach (-d), ossia in background.
Il parametro -p invece associa la porta locale 3000 a quella 8080 del container.
La dichiarazione della variabile WEBUI_AUTH=False (-e per environment, ambiente in italiano, per abbreviare "variabile di ambiente") evita la creazione obbligatoria di un account nell'interfaccia di Open WebUI, ma si può omettere per una configurazione multi-utente.
Dopo l'attesa necessaria per il download e l'avvio del container, è possibile raggiungere Open WebUI da un browser all'indirizzo localhost:3000 .
L'integrazione con Ollama permette di acquisire un modello semplicemente digitando il suo nome nella casella di ricerca in "Seleziona un modello", e poi cliccare su "Estrai [nome modello] da Ollama.com".
Per mantenere i dati dei modelli e delle conversazioni, è importante chiudere correttamente il container: $ podman stop openwebui E poi riaprilo, sempre specificando lo stesso nome: $ podman start openwebui
Dopo l'entusiasmo iniziale, non saprei dire quanto il gioco valga la candela.
Se avete hardware particolarmente recente e performante, magari con una scheda video dedicata degna di questo nome, una soluzione come Open WebUI, unita all'ottimizzazione dei modelli DeepSeek, potrebbe rappresentare potenzialmente la soluzione definitiva per la gestione di modelli linguistici di grandi dimensioni.
Con hardware modesto si può comunque sperimentare, ma niente miracoli.
Hai notato qualche errore?
Pensi che sia stato poco chiaro, magari dando per scontato un termine o un concetto che non riesci a capire?
Vuoi proporre un approccio differente all'argomento?
Contattami per feedback e chiarimenti, l'open source è anche questo!